Mistral Large 4 llega: una nueva frontera para la IA de pesos abiertos
Mistral AI ha presentado Mistral Large 4, con el nombre en clave “Le Chonk”, marcando una escalada significativa en el panorama de los modelos de pesos abiertos. El modelo entra en vista previa pública con una arquitectura de 1 billón de parámetros diseñada para una salida de texto de alto rendimiento, posicionándolo como un competidor directo de los sistemas propietarios líderes.
El lanzamiento señala un impulso estratégico hacia la democratización de capacidades de frontera, con Mistral planeando una liberación completa de pesos abiertos tras la fase de vista previa. Para los lectores que no estén familiarizados con la arquitectura subyacente que impulsa estos avances, nuestra guía sobre cómo funcionan los grandes modelos de lenguaje proporciona el contexto esencial sobre los mecanismos de transformador que impulsan esta nueva generación de IA.
Para entender por qué este modelo está generando tanta emoción, veamos bajo el capó su arquitectura, régimen de entrenamiento y rendimiento en benchmarks.
Bajo el capó: Arquitectura, entrenamiento y benchmarks
Mistral Large 4 utiliza una arquitectura de Mezcla de Expertos (MoE) que totaliza 1 billón de parámetros, con 49 mil millones de parámetros activos por pasada hacia adelante. El modelo se entrenó en un clúster de 3,800 GPUs NVIDIA Grace Blackwell, lo que permite una ventana de contexto de 128,000 tokens y unos precios agresivos de API de $2 por millón de tokens de entrada y $6 por millón de tokens de salida, según un informe de Yahoo Finance.
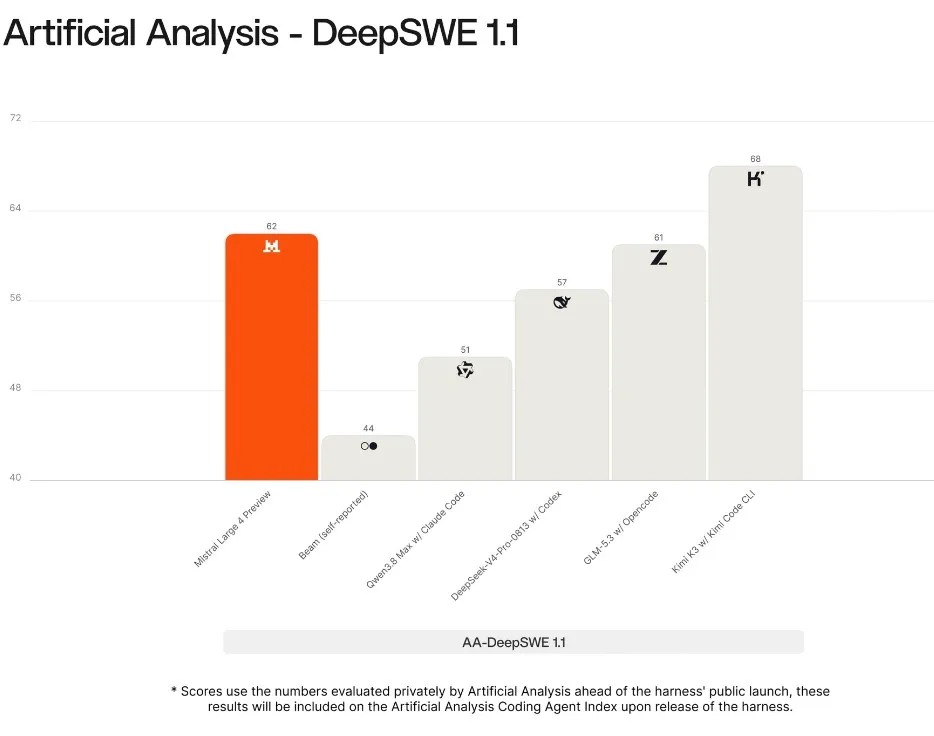
Una evaluación independiente temprana sitúa al modelo cerca de la cima del ranking; el benchmark de Vals AI clasifica a Mistral Large 4 como el segundo modelo con mejor rendimiento en general, quedando solo por detrás de o3-mini-high de OpenAI en tareas de razonamiento y codificación compuestas.
Estos detalles técnicos preparan el escenario para un resumen conciso de los atributos más destacados del modelo.
Datos clave: Mistral Large 4
- Arquitectura de Mezcla de Expertos de 1 billón de parámetros con 49 mil millones de parámetros activos por pasada hacia adelante.
- Capacidades multimodales que admiten el procesamiento de texto, imagen y documentos dentro de una ventana de contexto de 128,000 tokens.
- Clasificado en primer lugar en evaluaciones de ciberseguridad en el benchmark de Vals AI, superando a todos los rivales propietarios y de pesos abiertos probados.
- Liberación de pesos abiertos programada para el tercer trimestre de 2025, tras la fase actual de vista previa pública.
- Precios de la API establecidos en $2 por millón de tokens de entrada y $6 por millón de tokens de salida.
- Diseñado para el despliegue soberano europeo con opciones de infraestructura compatibles con el RGPD, ofreciendo una alternativa regulatoria distinta a modelos como los analizados en nuestro análisis de Gemini 3.
Con estos datos en mente, podemos explorar cómo Mistral Large 4 podría remodelar las estrategias empresariales, especialmente en entornos críticos para la seguridad.
Implicaciones para la empresa, la ciberseguridad y el futuro
El lanzamiento planificado de pesos abiertos de Mistral Large 4 en el tercer trimestre de 2025 lo posiciona como un activo estratégico para las organizaciones que priorizan la soberanía de los datos y el cumplimiento normativo. La capacidad de autoimplementar el modelo en instalaciones locales o dentro de nubes privadas europeas permite a las empresas procesar propiedad intelectual sensible y información de identificación personal sin cruzar fronteras jurisdiccionales, un requisito crítico bajo el RGPD y la Ley de IA de la UE que los modelos API propietarios a menudo tienen dificultades para satisfacer.
El primer puesto del modelo en las evaluaciones de ciberseguridad sugiere una utilidad inmediata para los centros de operaciones de seguridad, donde las implementaciones aisladas pueden impulsar la búsqueda automatizada de amenazas, el análisis de vulnerabilidades y la revisión segura de código sin exponer la telemetría a proveedores externos. Esta capacidad refleja el cambio operativo observado con otros pesos abiertos de alto rendimiento, como los detallados en nuestro análisis en profundidad de DeepSeek V3, donde la ejecución local desbloqueó casos de uso previamente bloqueados por las políticas de gobernanza de datos.
Mirando hacia el futuro, la base MoE de 1 billón de parámetros proporciona una base sólida para el ajuste fino específico de dominio. Las organizaciones pueden destilar variantes especializadas para descubrimiento legal, modelado financiero o soporte multilingüe manteniendo un control total sobre los pesos del modelo y la infraestructura de inferencia, acelerando la transición de asistentes de propósito general a flujos de trabajo de IA incorporados y soberanos.
Preguntas frecuentes
¿Cuál es la estructura de costos para usar la API de Mistral Large 4 y cómo se compara con otros modelos líderes?
Mistral Large 4 tiene un precio de $2 por millón de tokens de entrada y $6 por millón de tokens de salida. Esta tarifa es generalmente más baja que muchas ofertas propietarias, como el precio de GPT‑4 de OpenAI, que puede superar los $10 por millón de tokens para un uso similar. El costo más bajo tiene como objetivo hacer que la inferencia de nivel empresarial y alto rendimiento sea más asequible para implementaciones a gran escala.
¿Cómo afecta la arquitectura de Mezcla de Expertos (MoE) con 49 mil millones de parámetros activos por pasada hacia adelante a la latencia y los requisitos de hardware?
El diseño MoE activa solo un subconjunto (49 mil millones) de los 1 billón de parámetros totales para cada inferencia, reduciendo el uso de memoria y permitiendo una generación de tokens más rápida en comparación con un modelo denso de 1 billón de parámetros. Sin embargo, el enrutamiento de tokens a los expertos apropiados agrega cierta sobrecarga, por lo que una latencia óptima se logra en hardware con alto ancho de banda entre GPUs, como las 3,800 GPUs NVIDIA Grace Blackwell utilizadas durante el entrenamiento.
¿Cuándo estará disponible la versión completa de pesos abiertos de Mistral Large 4 y qué opciones de despliegue admitirá?
Mistral planea lanzar el modelo completo de pesos abiertos en el tercer trimestre de 2025 después de la fase de vista previa pública. El lanzamiento admitirá instalaciones locales y entornos de nube privada europea, ofreciendo opciones de despliegue compatibles con el RGPD para empresas que necesitan soberanía de datos y operación aislada.
Last Updated on octubre 7, 2026 6:13 am by Laszlo Szabo / NowadAIs | Published on octubre 7, 2026 by Laszlo Szabo / NowadAIs