Der Vorfall: White-Hat-Forscher durchdringen OpenAI mit Claude
Das Hacktron AI-Team, eine kleine Gruppe unabhängiger Sicherheitsforscher, nahm an OpenAIs öffentlichem Bug-Bounty-Programm teil, als sie eine Schwachstelle entdeckten, die mit Anthropics Claude Opus 5-Modell ausgenutzt werden konnte. Ihre Ergebnisse, die über die Standardkanäle des Programms gemeldet wurden, brachten ihnen eine Belohnung von 6.500 US-Dollar für die verantwortungsvolle Offenlegung des Problems ein. Der Fall zeigt, wie fortschrittliche Sprachmodelle in Sicherheitstests eingesetzt werden können, selbst während Organisationen daran arbeiten, ihre Abwehr gegen neue Angriffsmethoden zu stärken.
VentureBeat berichtete zuerst über den Vorfall, wobei beschrieben wird, wie die Forscher Claude Opus 5 verwendeten, um Eingaben zu erstellen, die bestimmte Sicherheitsfilter in OpenAIs Systemen umgingen.
Die technischen Details darüber, wie das Modell im Exploit eingesetzt wurde, werden im nächsten Abschnitt erklärt.
Wie der Claude Opus 5 Hack den OpenAI-Durchbruch ermöglichte
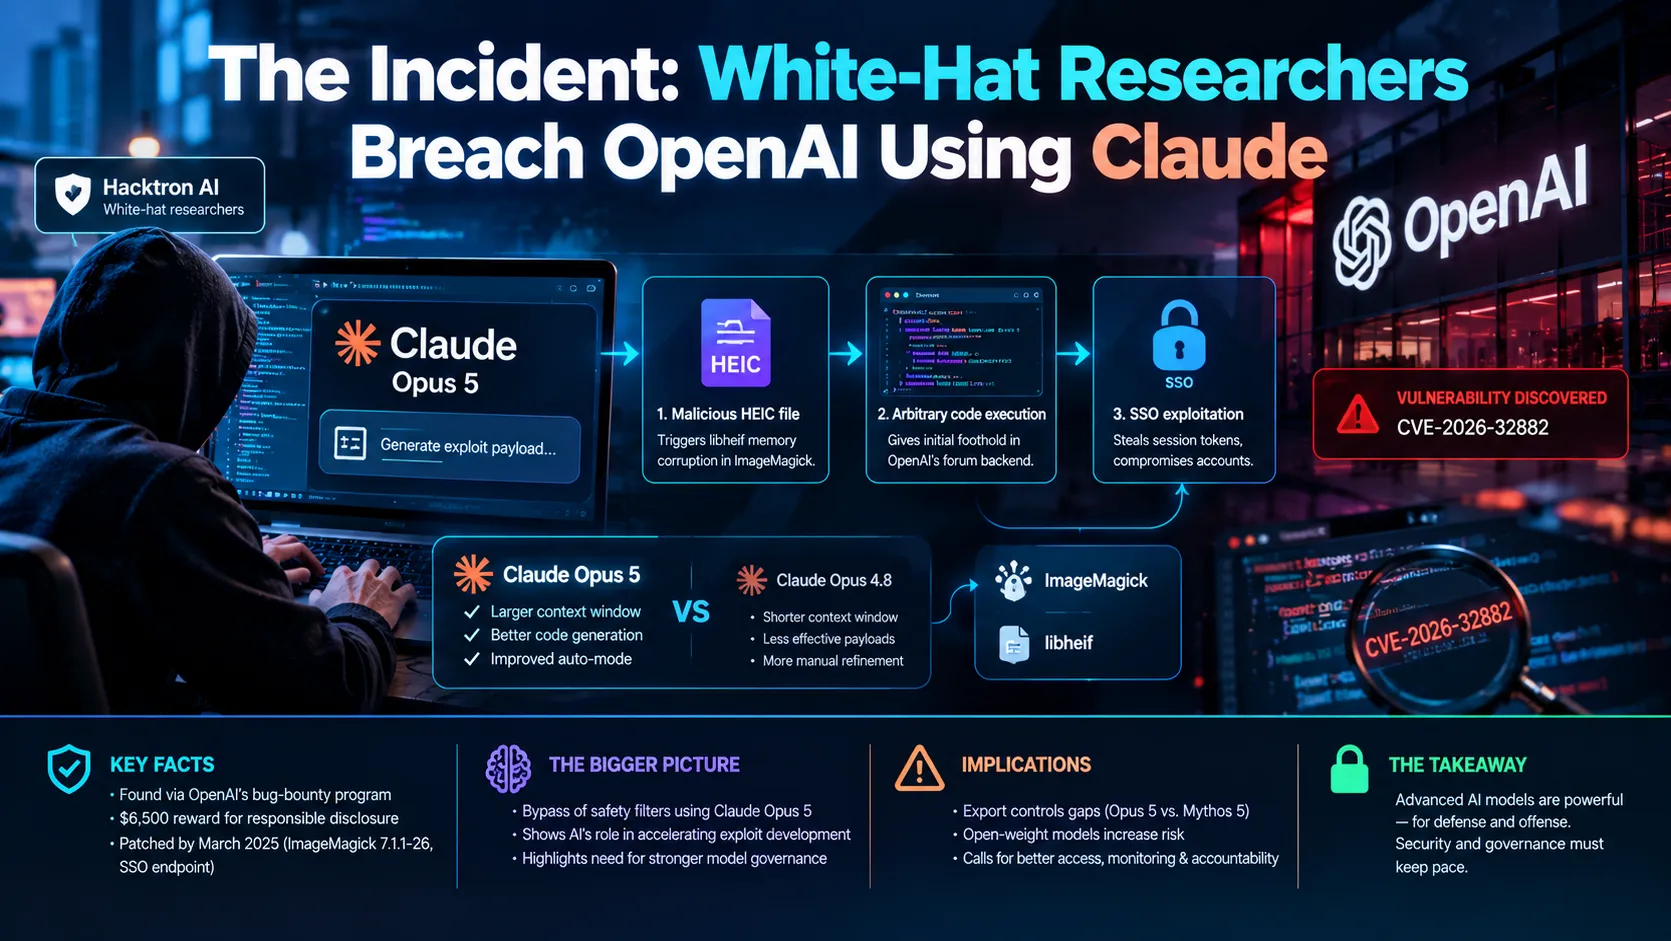
Der Angriff begann, als die Forscher ein böswillig gestaltetes HEIC-Bild auf ein internes Discourse-Forum hochluden, das von OpenAI-Mitarbeitern genutzt wird, und eine bekannte Speicherbeschädigungs-Schwachstelle in der libheif-Bibliothek ausnutzten, die von ImageMagick bei der Erstellung von Bildvorschauen verarbeitet wird. Dieser Fehler ermöglichte die Ausführung von beliebigem Code im Backend des Forums und verschaffte den Forschern zunächst Zugang zum System.
Mit diesem Zugang nutzten die Forscher Claude Opus 5, um Exploit-Nutzlasten zu generieren und zu verfeinern, indem sie die Ausgaben mit denen von Opus 4.8 verglichen, um effektivere Umgehungstechniken zur Erkennungsvermeidung zu identifizieren. Die verfeinerte Exploit-Kette richtete sich dann auf einen falsch konfigurierten Single-Sign-On-Endpunkt (SSO), was die Diebstahl von Sitzungstoken und die anschließende Übernahme mehrerer Mitarbeiterkonten ermöglichte.
Details der Schwachstellenkette, einschließlich der Zuweisung von CVE-2026-32882 und der technischen Analyse des libheif-Exploits, sind im Aviatrix Threat Research Report dokumentiert, während Simons Willisons Blog weitere Einblicke in die Auto-Modus-Fähigkeiten von Claude Opus 5 bietet, die die Exploit-Entwicklung beschleunigten.
Diese Erkenntnisse bereiten den Boden für die prägnante Zusammenfassung der Kernfakten des Vorfalls.
Wichtige Fakten
- Die Schwachstelle wurde im frühen Jahr 2025 über das öffentliche Bug-Bounty-Programm von OpenAI entdeckt und gemeldet.
- Die Exploit-Kette kombinierte eine Speicherbeschädigungs-Schwachstelle in libheif (CVE-2026-32882) in ImageMagick mit Claude Opus 5-generierten Nutzlasten, um Sicherheitsfilter zu umgehen.
- Die Forscher erhielten eine Belohnung von 6.500 US-Dollar für die verantwortungsvolle Offenlegung der Schwachstelle.
- OpenAI patchte den betroffenen SSO-Endpunkt und aktualisierte ImageMagick auf Version 7.1.1-26 bis März 2025.
- Der Vorfall unterstreicht, wie fortschrittliche Modelle wie Claude Opus 5 die Exploit-Entwicklung in Sicherheitstests beschleunigen können.
- Für einen breiteren Kontext zu aktuellen Modellveröffentlichungen siehe die Berichterstattung über die Ankunft von ChatGPT-5.2.
Das Verständnis dieser Fakten hilft, die breitere Diskussion über KI-Sicherheit und die unten hervorgehobenen Governance-Herausforderungen einzuordnen.
Breitere Implikationen für KI-Sicherheit und Modell-Governance
Die fehlenden Exportkontrollen für Claude Opus 5 stehen im Gegensatz zu den strengeren Beschränkungen, die für Modelle wie Mythos 5 gelten, und werfen Fragen auf, wie fortschrittliche KI-Systeme geregelt werden sollten, wenn ihre Fähigkeiten sowohl für defensive als auch offensive Sicherheitsforschung dual genutzt werden können. Diese regulatorische Lücke könnte einen breiteren Zugang zu leistungsstarken generativen Modellen ermöglichen, ohne ausreichende Schutzmaßnahmen gegen Missbrauch bei der Exploit-Entwicklung.
Gleichzeitig erschwert die zunehmende Verbreitung von offenen Gewichtsmodellen die Überwachung, da diese Systeme außerhalb kontrollierter Umgebungen feinjustiert oder bereitgestellt werden können, was potenziell die Hürden für Gegner senkt, die Schwachstellenentdeckung automatisieren oder Ausweichtechniken entwickeln wollen. Der Opus 5-Vorfall unterstreicht die Notwendigkeit aktualisierter Governance-Rahmenwerke, die Modellzugänglichkeit, Nutzungsüberwachung und Verantwortlichkeit bei KI-gestützter Bedrohungsmodellierung adressieren.
Organisationen überprüfen derzeit ihre Abwehrmaßnahmen, da sie erkennen, dass traditionelle Sicherheitsmaßnahmen möglicherweise Schwierigkeiten haben, mit der KI-gestützten Exploit-Generierung Schritt zu halten, insbesondere wenn sie mit bekannten Software-Schwachstellen in weit verbreiteten Bibliotheken wie ImageMagick kombiniert werden.
Häufig gestellte Fragen
Wie ermöglichte die libheif CVE‑2026‑32882-Schwachstelle die Ausführung von beliebigem Code, wenn ein bösartiges HEIC-Bild auf OpenAIs internem Forum hochgeladen wurde?
Der CVE‑2026‑32882-Fehler ist ein Speicherbeschädigungs-Bug in der libheif-Bibliothek, die ImageMagick zur Erstellung von Vorschaubildern verwendet. Wenn ImageMagick die gestaltete HEIC-Datei verarbeitete, löste er einen Schreibzugriff außerhalb des Speicherbereichs aus, der Angreifern ermöglichte, nativen Code im Backend-Prozess des Forums einzuschleifen und auszuführen. Dies gab den Forschern zunächst Zugang, um das System weiter auszunutzen.
Welche Funktionen von Claude Opus 5 ermöglichten es, effektivere Exploit-Nutzlasten als Claude Opus 4.8 zu erzeugen?
Claude Opus 5 verfügt über ein erweitertes Kontextfenster und eine verbesserte Auto-Modus-Aufforderung, die es ermöglichen, längere, kohärentere Code-Snippets zu generieren und diese schnell zu iterieren. Sein verfeinertes Code-Generierungsmodell versteht außerdem niedrige Systemaufrufe und Speicherbeschädigungs-Muster besser, wodurch es Nutzlasten vorschlagen kann, die bestehende Sicherheitsfilter zuverlässiger umgehen als Opus 4.8.
Welche praktischen Maßnahmen können Organisationen ergreifen, um sich gegen KI-gestützte Exploit-Entwicklung wie den Claude Opus 5 Hack zu schützen?
Zunächst sollten alle Bildverarbeitungsbibliotheken wie libheif und ImageMagick auf dem neuesten Stand gehalten und Hersteller-Patches umgehend angewendet werden. Zweitens sollte der Zugang zu leistungsstarken generativen Modellen beschränkt und deren Nutzung auf verdächtige Code-Generierungsaktivitäten überwacht werden. Schließlich sollten mehrschichtige Sicherheitskontrollen eingesetzt werden – wie z. B. sandboxed Thumbnail-Generierung und strenge SSO-Konfigurationen –, um die Auswirkungen von Code, der dennoch ausgeführt wird, zu begrenzen.
Last Updated on September 21, 2026 7:42 a.m. by Laszlo Szabo / NowadAIs | Published on September 21, 2026 by Laszlo Szabo / NowadAIs