Aumento en las ventas de libros usados genera alarma en Japón
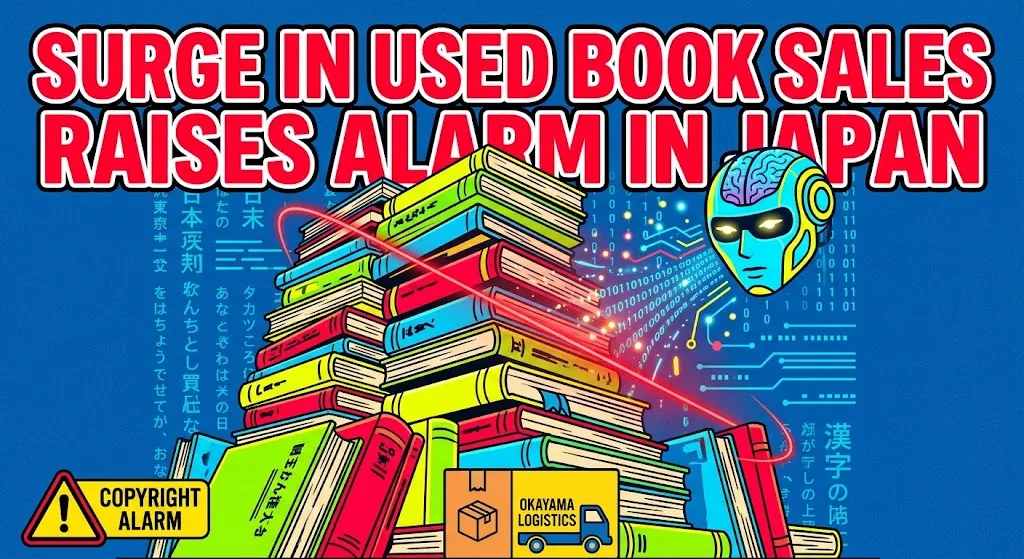
NTV Japón informó un aumento significativo en las compras masivas de libros usados en todo el país, con grandes volúmenes recolectados y enviados a un centro logístico en la prefectura de Okayama. Este patrón ha llamado la atención debido a la escala y velocidad de las adquisiciones, que incluyen títulos que van desde manuales técnicos hasta obras literarias. Los observadores de la industria sospechan que los libros están siendo recopilados para su procesamiento en el extranjero, potencialmente para su uso en el entrenamiento de modelos de inteligencia artificial mediante escaneo a gran escala y posterior destrucción. Estos desarrollos han llevado a los analistas a compilar los datos clave que ilustran el alcance del fenómeno.
Anthropic book scanning Japón: Datos clave
- Las ventas de libros usados en Japón aumentaron en 5 toneladas en un corto período debido a compras masivas.
- Un envío de aproximadamente 50 toneladas de libros recopilados fue enviado a los Estados Unidos.
- Los materiales adquiridos muestran un cambio notable hacia textos académicos y técnicos.
- Los libros se están consolidando en un centro logístico en la prefectura de Okayama para su procesamiento.
- La iniciativa ha generado preocupaciones legales y culturales sobre el uso de obras protegidas por derechos de autor sin autorización.
Comprender estos datos proporciona contexto para las implicaciones más amplias vinculadas al desarrollo de la IA y el uso de datos, que se exploran a continuación.
Anthropic book scanning Japón: Contexto e implicaciones
El aumento reportado en las adquisiciones de libros se alinea con los recientes avances de Anthropic en el desarrollo de modelos, particularmente el lanzamiento de Claude Opus 4.5, que subraya la creciente necesidad de la empresa de datos de entrenamiento diversos y de alta calidad. Como se detalla en la cobertura del lanzamiento del modelo, Anthropic continúa priorizando la escalabilidad de capacidades mediante una ingesta extensiva de datos, lo que plantea preguntas sobre los métodos de obtención y el cumplimiento de la propiedad intelectual.
Aunque la empresa no ha confirmado públicamente el uso de libros japoneses escaneados en el entrenamiento de sus modelos, el momento y la naturaleza del material recopilado—que muestra un cambio hacia contenido académico y técnico—sugieren una posible correlación con las demandas de datos de los sistemas de IA de próxima generación. Esta conexión destaca las tensiones más amplias de la industria entre el progreso de la IA y los límites legales de la utilización de datos.
Preguntas frecuentes
¿Cómo probablemente convierte Anthropic los libros japoneses escaneados en masa en datos de entrenamiento utilizables para Claude Opus?
Los libros se digitalizan primero con escáneres de alta resolución y se procesan mediante motores de OCR ajustados para caracteres japoneses. El texto resultante se limpia, tokeniza y alinea con corpus multilingües existentes antes de ser alimentado al pipeline de pre‑entrenamiento del modelo. Pasos adicionales como la deduplicación y el etiquetado de metadatos ayudan a garantizar que los datos mejoren la cobertura lingüística sin introducir ruido.
¿Qué desafíos legales podrían surgir de la compra masiva de libros usados en Japón para el entrenamiento de IA, y cómo aborda la ley de derechos de autor japonesa esto?
La ley de derechos de autor japonesa requiere permiso de los titulares de los derechos antes de reproducir o distribuir obras protegidas, incluso si los libros se compran de segunda mano. El uso de copias escaneadas para el entrenamiento comercial de IA podría considerarse una reproducción no autorizada, exponiendo a las empresas a reclamaciones por infracción y posibles daños. Algunos argumentan que la doctrina de la “primera venta” no cubre la copia digital, lo que hace que la práctica sea jurídicamente riesgosa sin licencias explícitas.
¿De qué manera podría añadir manuales técnicos japoneses al conjunto de entrenamiento de Claude Opus mejorar sus capacidades respecto a versiones anteriores?
Incorporar manuales técnicos japoneses amplía el vocabulario específico del dominio del modelo y mejora su capacidad para comprender y generar explicaciones técnicas precisas en japonés. Esta exposición más amplia puede impulsar el rendimiento en tareas como documentación de código, traducción científica y consultas específicas de la industria. Como resultado, Claude Opus podría mostrar una competencia multilingüe más fuerte y un razonamiento más preciso en temas especializados en comparación con versiones anteriores.
Last Updated on septiembre 24, 2026 7:24 pm by Laszlo Szabo / NowadAIs | Published on septiembre 24, 2026 by Laszlo Szabo / NowadAIs