Co-director de video de IA: el nuevo marco multiagente de Google para video de larga duración
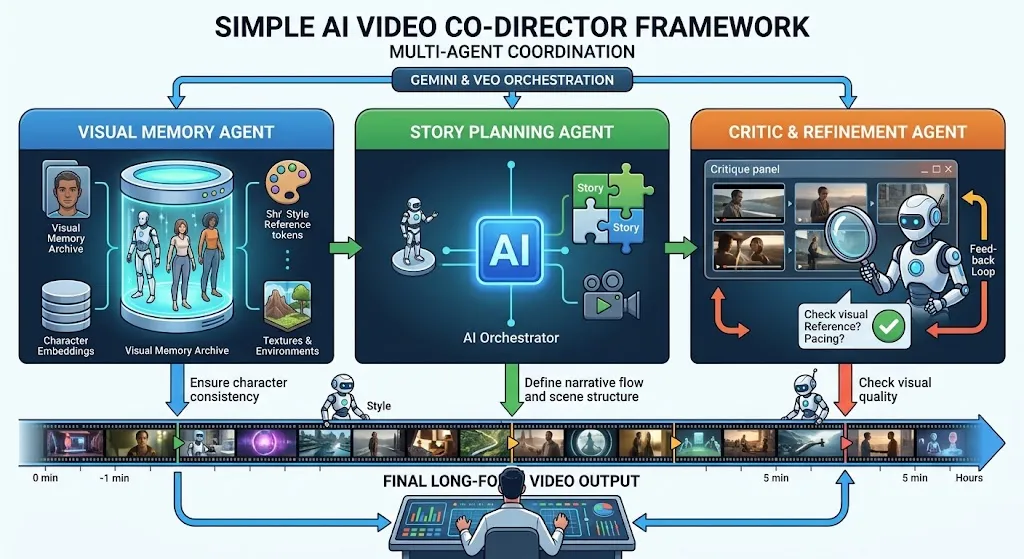
Google ha introducido el co-director de video de IA como una capa de orquestación que se sitúa encima de sus modelos Gemini y Veo, coordinando múltiples agentes especializados para gestionar las complejidades de la producción de larga duración. El sistema maneja la planificación de escenas, la consistencia de personajes y la continuidad temporal en narrativas extendidas — tareas que los enfoques de un solo modelo han tenido dificultades para resolver a escala.
Al delegar responsabilidades como la composición de tomas, la adherencia al estilo y el ritmo narrativo a agentes distintos, el marco busca mantener la coherencia visual y la lógica de la historia durante minutos o horas de material generado. Las investigaciones preliminares indican que este enfoque reduce los detalles alucinados y el parpadeo temporal que suelen acumularse en secuencias largas. Más detalles sobre la arquitectura y su integración con el razonamiento multimodal de Gemini están disponibles en las divulgaciones técnicas de Google. Los siguientes datos clave resumen las capacidades principales de este sistema multiagente.
Key Facts
- Multi-agent architecture coordinates specialized agents for scene planning, character consistency, and temporal continuity in long-form video generation.
- Framework operates as an orchestration layer atop Gemini and Veo models, translating high-level creative direction into frame-level synthesis instructions.
- Delegated responsibilities include shot composition, style adherence, and narrative pacing to maintain visual coherence across extended sequences.
- Early benchmarks show reduced hallucinated details and temporal flicker compared to single-model approaches for minutes-to-hours of footage.
- Leverages Gemini 3’s enhanced contextual understanding to interpret scripts, storyboards, and directorial intent with higher fidelity.
- Safety features include built-in content filtering at the agent level and consistency checks across the production pipeline to prevent policy violations.
Building on these fundamentals, Google’s architecture relies on three interlocking frameworks to achieve coherent storytelling.
Cómo CANVAS, A²RD y VQQA permiten una narración coherente
El sistema se basa en tres marcos entrelazados. CANVAS (Síntesis de Narrativa Audiovisual Consistente) actúa como una memoria visual persistente, almacenando incrustaciones de personajes, descriptores de entornos y tokens de estilo para que cada agente recupere los mismos datos de referencia al generar nuevas tomas. Este estado compartido evita el desplazamiento gradual en la apariencia y la iluminación que afecta a los generadores de un solo paso.
A²RD (Descomposición Recursiva de Agente a Agente) divide un guion en segmentos narrativos discretos y asigna cada uno a un agente director dedicado. Los agentes negocian las condiciones de contorno — como la pose de la cámara, el tono emocional y la colocación de objetos — antes de renderizar, asegurando que las transiciones entre segmentos permanezcan temporales y fluidas. La entrega recursiva también permite que los agentes anteriores revisen sus resultados cuando los segmentos posteriores revelan inconsistencias.
Finalmente, VQQA (Respuesta a Preguntas sobre Calidad Visual) proporciona un bucle de refinamiento basado en indicaciones. Un agente crítico plantea preguntas específicas — “¿La chaqueta del protagonista coincide con el marco de referencia?” — y el generador ajusta los códigos latentes hasta que la respuesta cumple con un umbral de calidad aprendido. Juntos, estos componentes forman una tubería de bucle cerrado que el artículo técnico describe como “consenso iterativo” en lugar de síntesis de un solo disparo. El enfoque refleja la filosofía de diseño modular vista en la orquestación de agentes de Google Opal, donde los módulos especializados coordinan mediante contratos explícitos en lugar de una alineación latente implícita. Estos mecanismos, en conjunto, moldean un nuevo flujo de trabajo para los creadores, redefiniendo cómo se construyen las narrativas de video.
Implicaciones para los creadores y el futuro del video impulsado por IA
La arquitectura multiagente cambia el rol del creador de la ingeniería de prompts cuadro a cuadro a una dirección creativa de alto nivel, permitiendo a los profesionales definir arcos narrativos, guías de estilo visual y biblia de personajes mientras el sistema se encarga de la ejecución a nivel de toma y la aplicación de la continuidad. Esta capa de abstracción podría comprimir los ciclos de previsualización e iteración de días a horas, especialmente para contenido episódico, series de marca y producciones educativas que requieren personajes consistentes en decenas de escenas. Los estudios que experimentan con la tubería informan de que los directores dedican más tiempo a refinar los momentos clave de la historia y menos tiempo a corregir el parpadeo temporal o la deriva de identidad.
Para los creadores independientes, el modelo de orquestación reduce la barrera técnica para la síntesis de largo formato al delegar la gestión de la consistencia a agentes especializados en lugar de requerir una manipulación manual del espacio latente. Los mismos contratos de agente que rigen CANVAS y A²RD también exponen ganchos programables para módulos de estilo personalizados, bibliotecas de activos y filtros de seguridad de marca, lo que sugiere una plataforma extensible en lugar de un producto cerrado. La investigación paralela de Google sobre sistemas de IA para videos más largos y consistentes indica que esta arquitectura continuará evolucionando hacia flujos de trabajo colaborativos en tiempo real donde los editores humanos y los agentes de IA negocian cortes, ritmo y continuidad visual en una línea de tiempo compartida.
Preguntas frecuentes
¿Cómo mantiene el co‑director de IA la consistencia de los personajes en secuencias largas en comparación con los generadores de video de un solo modelo?
El co‑director utiliza el marco CANVAS como una memoria visual persistente que almacena incrustaciones de personajes y tokens de estilo, los cuales cada agente especializado consulta al crear nuevas tomas. Esta referencia compartida evita el desplazamiento en la apariencia y la iluminación, mientras que las herramientas de un solo modelo generan cada fotograma de forma independiente y a menudo pierden consistencia con el tiempo.
¿Cuáles son las implicaciones computacionales y de latencia al ejecutar el pipeline multiagente (CANVAS, A²RD, VQQA) para la generación de videos de una hora?
Cada agente se ejecuta como una tarea de inferencia independiente sobre los modelos Gemini y Veo, por lo que el sistema requiere múltiples GPUs o núcleos de TPU para paralelizar la planificación de escenas, la generación y la verificación de calidad. Si bien la orquestación añade una sobrecarga, las entregas recursivas y el refinamiento selectivo suelen mantener la latencia de extremo a extremo comparable a la de un modelo de alta capacidad individual, pero el costo total de cómputo es mayor debido a las múltiples pasadas.
¿Pueden los desarrolladores extender o reemplazar componentes como el crítico VQQA dentro de la arquitectura del co‑director de video de IA de Google, y qué opciones de integración están disponibles?
Google proporciona una capa de API que expone los contratos de los agentes, lo que permite a los desarrolladores conectar módulos de crítico personalizados o sustituir VQQA con modelos alternativos de evaluación de calidad. El marco espera que el reemplazo se ajuste a la misma interfaz de pregunta‑respuesta basada en indicaciones y que devuelva una puntuación de confianza que la capa de orquestación pueda utilizar para el refinamiento iterativo.
Last Updated on septiembre 25, 2026 7:47 pm by Laszlo Szabo / NowadAIs | Published on septiembre 25, 2026 by Laszlo Szabo / NowadAIs