AI videó co-regizsor: Google új több-ügynökös keretrendszere a hosszú formátumú videókhoz
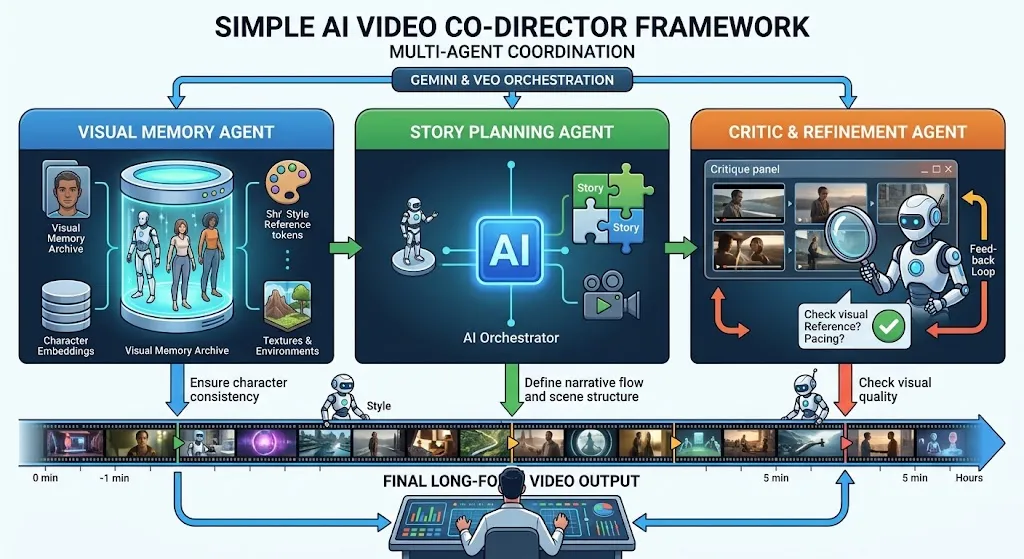
Google bevezette az AI videó co-regizsort egy orchestrációs rétegként, amely a Gemini és Veo modellek felett helyezkedik el, több speciális ügynököt koordinálva a hosszú formátumú termelési bonyolultságok kezeléséhez. A rendszer kezeli a jelenet-tervezést, a karakterkonzisztenciát, és a temporális folytonosságot a kiterjedt naratívákon keresztül — feladatok, amelyek egyetlen modell megközelítései nehezen tudnak skálázhatóan megoldani.
Az ügynökök közötti felelősségelosztás révén, mint például a kompozíció, a stílus betartása és a naratív tempó, a keretrendszer célja, hogy a vizuális koherencia és a történelmi logika megmaradjon percek vagy órák hosszú generált videóban. A korai kutatások azt jelezik, hogy a megközelítés csökkenti a halucinált részleteket és a temporális villogást, amelyek tyúkszerűen halmozódnak a hosszú szekvenciákban. További részletek az architektúráról és az integrációjáról a Gemini multimódális okosságával a Google technikai dokumentációjában olvashatók. Az alábbi kulcsfontosságú tények összefoglalják a több-ügynökös rendszer alapvető képességeit.
Key Facts
- Multi-agent architecture coordinates specialized agents for scene planning, character consistency, and temporal continuity in long-form video generation.
- Framework operates as an orchestration layer atop Gemini and Veo models, translating high-level creative direction into frame-level synthesis instructions.
- Delegated responsibilities include shot composition, style adherence, and narrative pacing to maintain visual coherence across extended sequences.
- Early benchmarks show reduced hallucinated details and temporal flicker compared to single-model approaches for minutes-to-hours of footage.
- Leverages Gemini 3’s enhanced contextual understanding to interpret scripts, storyboards, and directorial intent with higher fidelity.
- Safety features include built-in content filtering at the agent level and consistency checks across the production pipeline to prevent policy violations.
Building on these fundamentals, Google’s architecture relies on three interlocking frameworks to achieve coherent storytelling.
Hogyan teszik lehetővé a CANVAS, A²RD és VQQA a koherens történelmű elmesélést
A rendszer három egymással összefüggő keretrendszerre támaszkodik. A CANVAS (Consistent Audio-Visual Narrative Synthesis) egy állandó vizuális memóriaként működik, amely a karakterbeágyazásokat, környezetleírásokat és stílusjeleket tárolja, így minden ügynök ugyanazt a referenciadatot kapja, amikor új képeket genereer. Ez az állapot megosztása megakadályozza az együtköző generátoroknál tapasztalható lassú eltérést a megjelenésben és a fényben.
A²RD (Agent-to-Agent Recursive Decomposition) egy szkriptet különálló történelmi szegmensekre bont, és mindegyikhez egy dedikált reżisző ügynököt rendel. Az ügynökök előzetesen tárgyalják a határfeltételeket — például a kamerapózíciót, az érzelmi hangulatot és az objektum elhelyezését — a renderelés előtt, így biztosítva, hogy a szegmensek közötti átmenetek időileg simák maradjanak. A rekurzív átadás lehetővé teszi, hogy az előző ügynökök módosítsák kimeneteiket, ha a későbbi szegmensek inkonzisztenciákat felfedeznek.
Végül a VQQA (Visual Quality Question Answering) prompt-alapú javítási hurokot biztosít. Egy kritik ügynök célzott kérdéseket tesz fel — például „A protagonist kabátja egyezik a referenciáképével?” — és a generátor a latent kódokat állítja, amíg a válasz egy megtanult minőségi küszöböt nem teljesít. Ezek az összetevők egy záró körhurok csővezetéket alkotnak, amelyet a technikai cikk „iteratív egyeztetésnek” nevez együtköző szintézis helyett. A megközelítés tükrözi a Google Opal ügynök-orchestralása modularis tervezési filozófiáját, ahol a specializált modulok explicit szerződések révén koordinálnak, helyett az implicit latent egyezésen. Ezek a mechanizmusok együtt alakítják ki a létrehozók új munkafolyamát, újradefiniálva, hogyan épülnek fel a videotörténetek.
Implications for creators and the future of AI‑driven video
The multi-agent architecture shifts the creator’s role from frame-by-frame prompt engineering to high-level creative direction, letting professionals define narrative arcs, visual style guides, and character bibles while the system handles shot-level execution and continuity enforcement. This abstraction layer could compress pre‑visualization and iteration cycles from days to hours, particularly for episodic content, branded series, and educational productions that demand consistent characters across dozens of scenes. Studios experimenting with the pipeline report that directors spend more time refining story beats and less time correcting temporal flicker or identity drift.
For independent creators, the orchestration model lowers the technical barrier to long-form synthesis by offloading consistency management to specialized agents rather than requiring manual latent‑space wrangling. The same agent contracts that govern CANVAS and A²RD also expose programmable hooks for custom style modules, asset libraries, and brand‑safety filters, suggesting an extensible platform rather than a closed product. Google’s parallel research into AI systems for longer, more consistent videos indicates this architecture will continue evolving toward real-time collaborative workflows where human editors and AI agents negotiate cuts, pacing, and visual continuity in a shared timeline.
Gyakori kérdések
Hogyan tartja fenn az AI videó co‑director a karakteregységesítést a hosszú szekvenciákon, egyedi modellű videogenerátorokhoz képest?
A co‑director a CANVAS keretrendszert használja állandó vizuális memóriaként, amely a karakterbeágyazásokat és stílusjeleket tárolja, és amelyet minden specializált ügynök lekérdez új képek generálásakor. Ez a megosztott referencia megakadályozza a megjelenés és fény eltérését, míg az egyedi modellű eszközök minden képet függetlenül generálnak, és gyakran elvesztik az egységesítést az idővel.
Milyen számítási és késleltetési következményekkel jár az órás videogeneráláshoz szükséges több ügynökből álló folyamat (CANVAS, A²RD, VQQA) futtatása?
Minden ügynök különálló inferenciát feladatként futtat a Gemini és Veo modelleken, így a rendszer több GPU‑t vagy TPU‑magot igényel a scène-tervezés, generálás és minőség‑ellenőrzés párhuzamosításához. Bár az orchestrálás overhead‑ot jelent, a rekurzív átadások és a szélsőséges javítások általában összehasonlítható végpontok közötti késleltetést tartanak fenn egy egyedi nagykapacitású modellhez képest, de az összes számítási költség magasabb, mert több átszámolásra van szükség.
Fejleszthetők vagy cserélhetők‑e az összetevők, például a VQQA kritikus a Google AI videó co‑director architektúrájában, és milyen integrációs lehetőségek állnak rendelkezésre?
Google API réteget biztosít, amely kitéti az ügynök szerződéseket, lehetővé téve a fejlesztők számára, hogy beillesztőni egyéni kritikus modulokat vagy cseréljék le a VQQA‑t alternatív minőség‑értékelő modellekkel. A keretrendszer azt várja el a cserélendő komponenstől, hogy kövesse ugyanazt a prompt‑alapú kérdés‑válasz interfészt, és visszaadjon egy bizalmi pontszámot, amelyet az orchestrálási réteg iteratív javításra használhat.
Last Updated on szeptember 25, 2026 7:49 du. by Laszlo Szabo / NowadAIs | Published on szeptember 25, 2026 by Laszlo Szabo / NowadAIs