Meta’s neueste KI-Frontier-Modelle
Meta hat die Muse Wonder-Serie eingeführt, eine neue Familie von Frontier-Modellen, die entwickelt wurde, um multimodales Denken und agentische Fähigkeiten in seinem Ökosystem voranzutreiben. Die Veröffentlichung signalisiert einen strategischen Vorstoß, Forschungserfolge im Bereich des langen Kontextverständnisses, der Werkzeugnutzung und der Echtzeit-Interaktion unter einer einzigen Modelllinie zu vereinen, um das Unternehmen in die Lage zu versetzen, direkt mit integrierten Angeboten der Konkurrenten zu konkurrieren.
Architektonisch baut Muse Wonder auf den dichten Transformer-Grundlagen auf, die modernen großen Sprachmodellen gemeinsam sind, und integriert gleichzeitig das sparse Mixture-of-Experts-Routing, um die Parameteranzahl effizient zu skalieren. Dieser Ansatz spiegelt den branchenweiten Trend zu modularen, compute-optimalen Designs wider, wie er in Googles Gemini 3 zu sehen ist, wo spezialisierte Teilnetzwerke unterschiedliche Modalitäten verarbeiten, ohne das vollständige Modell für jedes Token zu aktivieren.
Für Entwickler und Forscher, die die Entwicklung von Foundation-Modellen verfolgen, stellt Muse Wonder ein praktisches Fallbeispiel dar, wie große Sprachmodelle funktionieren an der Front: das Gleichgewicht zwischen Vortrainingsumfang, Nachschulungsausrichtung und Inferenzzeit-Flexibilität zu finden, um generalisierte Intelligenz über Text-, Bild- und strukturierte Datenaufgaben hinweg zu liefern.
Mit dieser technischen Grundlage ist der nächste Schritt, die konkreten Fähigkeiten zu erkunden, die Muse Wonder für reale Anwendungen auszeichnen.
Kernfunktionen: Aktives Gedächtnis, Aktiver Fokus und Programmierung
Aktives Gedächtnis verleiht Muse Wonder einen persistenten, abfragbaren Kontextspeicher, der Sitzungen überdauert, sodass das Modell Fakten, Präferenzen und frühere Denkspuren abrufen kann, ohne vollständige Gesprächsverläufe erneut einzuspeisen. Die offizielle Ankündigung von Meta beschreibt den Mechanismus als einen während der Inferenz aktualisierten differenzierbaren Schlüssel-Wert-Cache, der langfristige Aufgaben wie mehrtägige Forschungsworkflows oder personalisierte Assistenten ermöglicht, die projektspezifisches Wissen über Interaktionen hinweg behalten.
Aktiver Fokus führt eine dynamische Rechenzuweisung ein, die es dem Modell erlaubt, Tokens basierend auf Aufgabenanforderungen durch spezialisierte Experten-Unternetzwerke zu routen – es weist komplexen Codierungs- oder Mathematikproblemen eine höhere Rechenkapazität zu, während es für routinemäßigen Dialog leichtere Pfade nutzt. Der Entwickler-Blog weist darauf hin, dass diese dünn besetzte Routing-Technik die Inferenzlatenz bei gemischten Workloads im Vergleich zu dichten Baselines um bis zu 40 Prozent senkt und API-Steuerelemente freigibt, damit Entwickler Fokusmodi pro Anfrage hinweisen können.
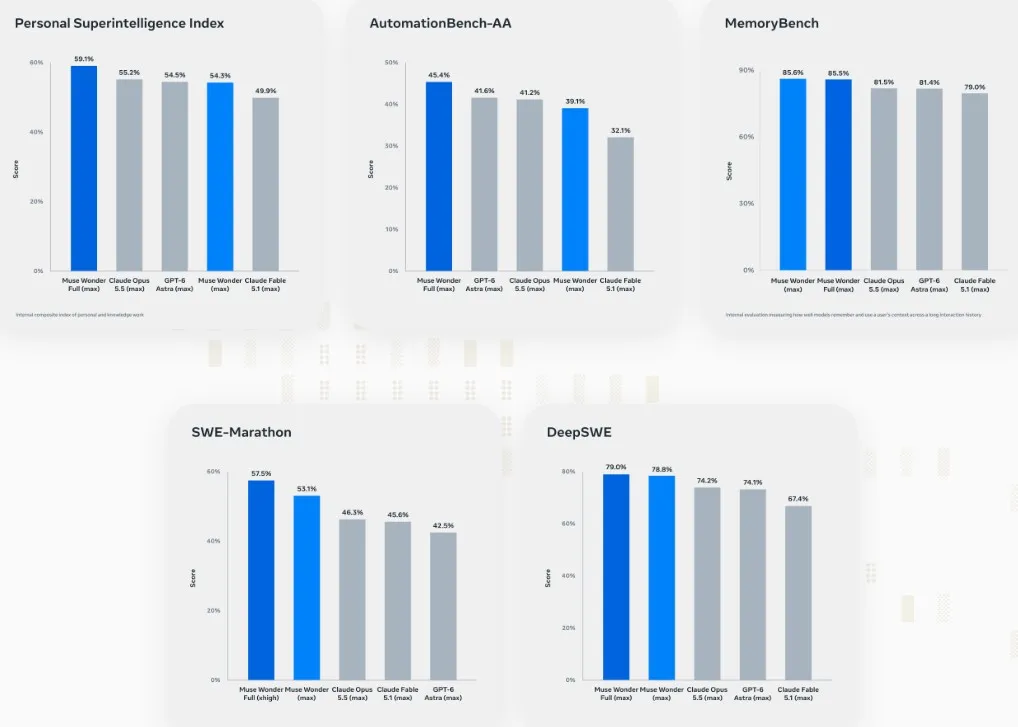
Beim Frontier-Coding erreicht Muse Wonder state-of-the-art Bestehensraten bei SWE‑bench Verified und HumanEval+, indem es repository-weites Kontext-Einspeisen mit tool-erweiterten Generierungszyklen kombiniert, die Patches autonom schreiben, testen und iterieren. Das Modell unterstützt spekulatives Decodieren für parallele Patch-Vorschläge und ist nativ in Metas interne CI-Infrastruktur integriert – eine Funktion, die das Unternehmen zufolge in externen IDE-Plugins im kommenden Quartal ausgerollt wird.
Diese Funktionen werden in einem prägnanten Faktenblatt zusammengefasst, das die Spezifikationen, die Leistung und die Preise des Modells hervorhebt.
Wichtige Fakten zu Muse Wonder
- Modellvarianten: Muse Wonder (Flaggschiff) und Muse Wonder Lite (destilliert, geringere Latenz) verfügbar über OpenRouter.
- Kontextfenster: 128.000 Tokens für beide Varianten.
- Preis (pro 1M Tokens): Muse Wonder bei 3,00 $ Eingabe / 15,00 $ Ausgabe; Muse Wonder Lite bei 0,60 $ Eingabe / 2,40 $ Ausgabe.
- Benchmarks: 92,7 % bei MMLU‑Pro, 72,4 % bei SWE‑bench Verified und 89,1 % bei HumanEval+ für das Flaggschiffmodell.
- Multimodale Unterstützung: nativer Text-, Bild- und strukturierter Datenverarbeitung mit Tool‑Use- und Function‑Calling‑APIs.
- Bereitstellung: serverlose Endpunkte mit pro-Anfrage-Aktiver-Fokus-Routing-Steuerung und spekulativem Decodieren für Coding-Workflows.
Nachdem die Kernspezifikationen dargelegt wurden, ist es nützlich zu verstehen, wie Entwickler Muse Wonder tatsächlich erhalten und verwenden können sowie welche Sicherheitsvorkehrungen den Dienst begleiten.
Verfügbarkeit, Preisgestaltung und Sicherheitsaspekte
Entwickler können Muse Wonder über die Meta Model API und die Muse Code-Umgebung zugreifen, die serverlose Endpunkte mit pro-Anfrage-Steuerung für den Aktiven Fokus-Routing und spekulatives Decodieren bereitstellen. Die Preisgestaltung folgt einer Struktur pro Million Tokens: Das Flaggschiffmodell kostet 3,00 $ für Eingabe und 15,00 $ für Ausgabe, während Muse Wonder Lite bei 0,60 $ Eingabe und 2,40 $ Ausgabe liegt, wodurch die Produktreihe wettbewerbsfähig gegenüber aktuellen Releases wie ChatGPT 5.2 positioniert wird.
Sicherheitstools umfassen eingebaute Inhaltsfilterung, konfigurierbare Ablehnungsschwellenwerte und Audit-Protokollierung für Unternehmensbereitstellungen. Meta veröffentlicht außerdem Modellkarten, die Red-Teaming-Ergebnisse für Cybersicherheit, biologisches Risiko und Überzeugungsbenchmarks detaillieren, und verlangt die Annahme eines verantwortungsvollen Nutzungszusatzes, bevor Produktions-API-Schlüssel ausgestellt werden.
Häufig gestellte Fragen
Wie unterscheidet sich die Preisgestaltung von Muse Wonder pro Token von Muse Wonder Lite, und worauf sollten Entwickler achten, wenn sie Kosten für große Eingabe- versus Ausgabemengen schätzen?
Muse Wonder kostet 3,00 $ pro Million Eingabetoken und 15,00 $ pro Million Ausgabtoken, während die Lite-Variante bei 0,60 $ für Eingabe und 2,40 $ für Ausgabe pro Million Token liegt. Da die Ausgabe beim Flaggschiffmodell fünfmal teurer ist als die Eingabe, können Workloads mit langen Antworten schnell die Kosten dominieren. Entwickler sollten daher die erwartete Ausgabelänge bewerten und die Lite-Variante für latenzsensible oder kostengünstigere Szenarien in Betracht ziehen.
Was ist das Active Memory-Feature in Muse Wonder und wie kann es genutzt werden, um Kontext über separate API-Anfragen hinweg zu bewahren?
Active Memory bietet einen persistenten, abfragbaren Schlüssel-Wert-Cache, der Fakten, Präferenzen und Reasoning-Traces während der Inferenz speichert, sodass das Modell Informationen abrufen kann, ohne den vollständigen Conversation-Verlauf erneut zu senden. Entwickler können den Cache über API-Flags aktivieren und gespeicherte Einträge in späteren Aufrufen abrufen, was für mehrtägige Forschungsassistenten oder personalisierte Agenten nützlich ist, die projektspezifisches Wissen über Sitzungen hinweg behalten müssen.
Wie schneiden die Coding-Benchmarks von Muse Wonder im Vergleich zu konkurrierenden Modellen wie Google Gemini 3 ab, und was bedeutet das für Entwickler, die ein Modell für Codegenerierung auswählen?
Muse Wonder erreicht 72,4 % beim SWE‑bench Verified-Benchmark und 89,1 % bei HumanEval+, was es auf oder über dem Stand der Technik platziert, der für Gemini 3 in ähnlichen Tests berichtet wird. Diese starke Codierungsleistung, kombiniert mit spekulativem Decodieren und tool‑augmentierter Generation, macht es zu einer überzeugenden Wahl für Entwickler, die hochwertige, autonome Code-Patches benötigen, insbesondere wenn es mit IDE-Plugins oder CI-Pipelines integriert wird.
Last Updated on Oktober 12, 2026 7:19 p.m. by Laszlo Szabo / NowadAIs | Published on Oktober 12, 2026 by Laszlo Szabo / NowadAIs