Los últimos modelos fronterizos de IA de Meta
Meta ha presentado la serie Muse Wonder, una nueva familia de modelos fronterizos diseñada para avanzar en el razonamiento multimodal y las capacidades agénticas a lo largo de su ecosistema. El lanzamiento señala un impulso estratégico para unificar los avances de investigación en comprensión de contexto largo, uso de herramientas e interacción en tiempo real bajo una única línea de modelos, posicionando a la empresa para competir directamente con las ofertas integradas de sus rivales.
Arquitectónicamente, Muse Wonder se basa en las fundaciones de transformador denso comunes a los grandes modelos de lenguaje modernos, incorporando el enrutamiento de mezcla de expertos dispersos para escalar eficientemente el conteo de parámetros. Este enfoque refleja el cambio generalizado de la industria hacia diseños modulares y óptimos en cómputo, como se observa en el modelo de IA Gemini 3 de Google, donde subredes especializadas manejan distintas modalidades sin activar el modelo completo para cada token.
Para desarrolladores e investigadores que siguen la evolución de los modelos fundacionales, Muse Wonder representa un caso práctico de estudio sobre cómo funcionan los grandes modelos de lenguaje en la frontera: equilibrando la escala de pre‑entrenamiento, la alineación post‑entrenamiento y la flexibilidad en tiempo de inferencia para ofrecer inteligencia generalizada en tareas de texto, imagen y datos estructurados.
Con esta base técnica establecida, el siguiente paso es explorar las capacidades concretas que distinguen a Muse Wonder para aplicaciones del mundo real.
Capacidades principales: Memoria activa, Enfoque activo y Codificación
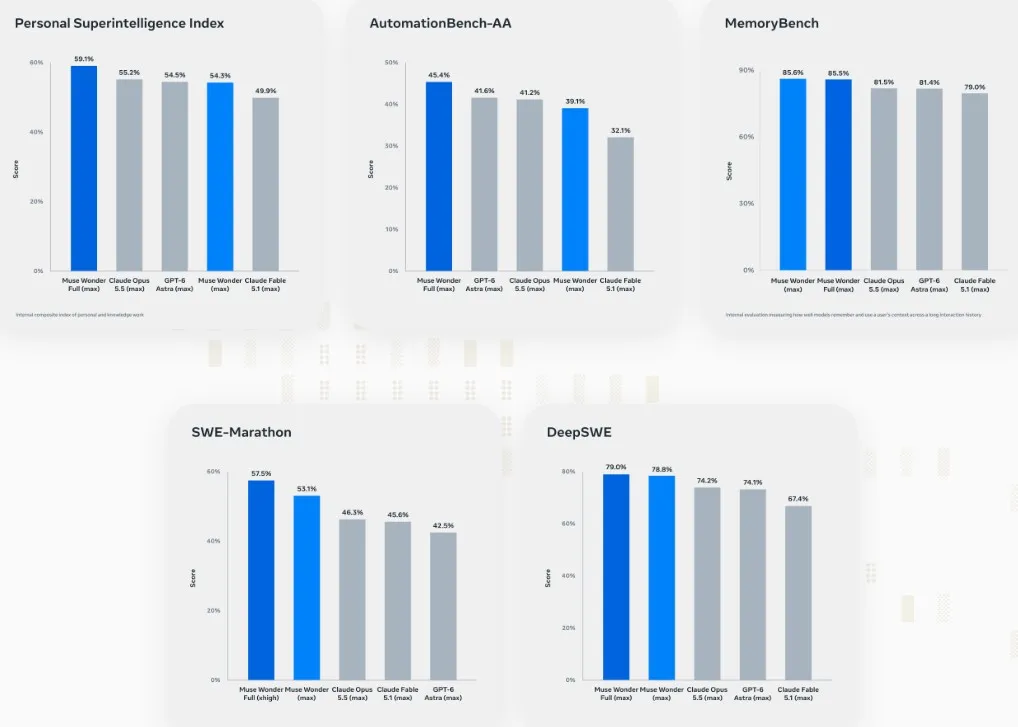
La Memoria activa equipa a Muse Wonder con un almacén de contexto persistente y consultable que abarca sesiones, permitiendo al modelo recordar hechos, preferencias y rastros de razonamiento previo sin volver a alimentar historiales completos de conversación. El anuncio oficial de Meta describe el mecanismo como una caché clave-valor diferenciable actualizada durante la inferencia, lo que permite tareas de largo horizonte como flujos de trabajo de investigación de varios días o asistentes personalizados que retienen conocimiento específico de proyectos entre interacciones.
El Enfoque activo introduce una asignación dinámica de cómputo, permitiendo que el modelo dirija tokens a través de subredes expertas especializadas según las demandas de la tarea—dedicando mayor capacidad de razonamiento a problemas complejos de codificación o matemáticas mientras utiliza rutas más ligeras para el diálogo rutinario. El blog para desarrolladores señala que este enrutamiento disperso reduce la latencia de inferencia hasta en un 40 por ciento en cargas de trabajo mixtas en comparación con líneas base densas, y expone controles de API para que los desarrolladores sugieran modos de enfoque por solicitud.
En codificación de frontera, Muse Wonder alcanza tasas de paso de última generación en SWE‑bench Verified y HumanEval+ al combinar la ingestión de contexto a escala de repositorio con ciclos de generación aumentados por herramientas que escriben, prueban e iteran parches de forma autónoma. El modelo admite decodificación especulativa para propuestas paralelas de parches y se integra nativamente con la infraestructura interna de CI de Meta, una capacidad que la empresa afirma se implementará en plugins externos de IDE en el próximo trimestre.
Estas capacidades se resumen en una hoja de datos concisa que destaca las especificaciones, el rendimiento y los precios del modelo.
Datos clave sobre Muse Wonder
- Variantes del modelo: Muse Wonder (modelo insignia) y Muse Wonder Lite (distilado, menor latencia) disponibles a través de OpenRouter.
- Ventana de contexto: 128,000 tokens para ambas variantes.
- Precios (por 1M tokens): Muse Wonder a $3.00 de entrada / $15.00 de salida; Muse Wonder Lite a $0.60 de entrada / $2.40 de salida.
- Referencias: 92.7% en MMLU‑Pro, 72.4% en SWE‑bench Verified y 89.1% en HumanEval+ para el modelo insignia.
- Soporte multimodal: procesamiento nativo de texto, imagen y datos estructurados con APIs de uso de herramientas y llamadas a funciones.
- Implementación: puntos finales sin servidor con controles de enrutamiento de Enfoque activo por solicitud y decodificación especulativa para flujos de trabajo de codificación.
Tras describir las especificaciones principales, resulta útil comprender cómo los desarrolladores pueden obtener y usar realmente Muse Wonder, así como las salvaguardas que acompañan al servicio.
Disponibilidad, Precios y Consideraciones de Seguridad
Los desarrolladores pueden acceder a Muse Wonder a través de la API de modelos de Meta y el entorno Muse Code, que proporcionan puntos finales sin servidor con controles por solicitud para el enrutamiento de Enfoque activo y decodificación especulativa. Los precios siguen una estructura por millón de tokens: el modelo insignia se ejecuta a $3.00 para entrada y $15.00 para salida, mientras que Muse Wonder Lite tiene un precio de $0.60 de entrada y $2.40 de salida, posicionando la línea competitivamente frente a lanzamientos recientes como ChatGPT 5.2.
Las herramientas de seguridad incluyen filtrado de contenido incorporado, umbrales de rechazo configurables y registro de auditoría para implementaciones empresariales. Meta también publica fichas de modelo que detallan los resultados de pruebas de equipo rojo para ciberseguridad, riesgo biológico y benchmarks de persuasión, y requiere la aceptación de un adendum de uso responsable antes de emitir claves de API para producción.
Preguntas frecuentes
¿En qué se diferencia el precio por token de Muse Wonder respecto a Muse Wonder Lite, y qué deben considerar los desarrolladores al estimar costos para volúmenes grandes de entrada versus salida?
Muse Wonder cuesta $3.00 por millón de tokens de entrada y $15.00 por millón de tokens de salida, mientras que la variante Lite tiene un precio de $0.60 para entrada y $2.40 para salida por millón de tokens. Dado que la salida es cinco veces más cara que la entrada en el modelo flagship, las cargas de trabajo que generan respuestas largas pueden dominar rápidamente la factura. Los desarrolladores deben, por lo tanto, evaluar la longitud esperada de la salida y considerar Lite para escenarios sensibles a la latencia o de menor costo.
¿Qué es la función de Memoria Activa en Muse Wonder y cómo puede utilizarse para preservar el contexto entre solicitudes de API separadas?
Memoria Activa proporciona una caché persistente y consultable de clave-valor que almacena hechos, preferencias y rastros de razonamiento durante la inferencia, permitiendo que el modelo recuerde información sin volver a enviar todo el historial de la conversación. Los desarrolladores pueden habilitar la caché mediante banderas de API y recuperar las entradas almacenadas en llamadas posteriores, lo cual es útil para asistentes de investigación de varios días o agentes personalizados que necesitan retener conocimientos específicos del proyecto entre sesiones.
¿Cómo se comparan los benchmarks de codificación de Muse Wonder con los de modelos competidores como Google Gemini 3, y qué significa eso para los desarrolladores que eligen un modelo para generación de código?
Muse Wonder logra un 72.4% en el benchmark SWE‑bench Verified y un 89.1% en HumanEval+, colocándolo en o por encima del rendimiento de vanguardia reportado para Gemini 3 en pruebas similares. Esta sólida competencia en codificación, combinada con su decodificación especulativa y generación aumentada por herramientas, lo convierte en una opción atractiva para desarrolladores que necesitan parches de código de alta calidad y autónomos, especialmente cuando se integra con plugins de IDE o pipelines de CI.
Last Updated on octubre 12, 2026 7:20 pm by Laszlo Szabo / NowadAIs | Published on octubre 12, 2026 by Laszlo Szabo / NowadAIs