HomeBody VLM: Bridging Vision and Action
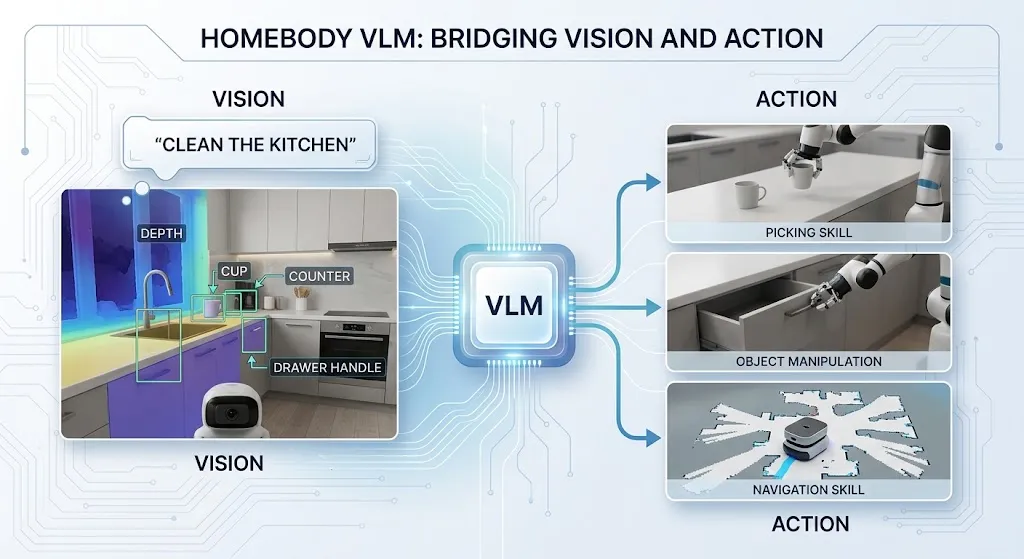
Das HomeBody-System führt eine modulare Architektur ein, bei der ein Vision-Language-Modell als semantische Reasoning-Schicht über einer Bibliothek wiederverwendbarer Roboterfähigkeiten dient. Anstatt für jede neue Umgebung eine End-to-End-Policy zu trainieren, interpretiert das VLM hochstufige Anweisungen und visuelle Beobachtungen, um vorhandene Fähigkeiten auszuwählen und zu parametrisieren—wie Navigation, Greifen oder Objektmanipulation—was eine Null-Schuss-Generalisierung in bisher unbekannten Häusern ermöglicht.
Dieser Plug-in-Ansatz behandelt das VLM als austauschbares kognitives Modul, das Wahrnehmung und Reasoning von der niedrigstufigen Steuerung entkoppelt. Forscher haben kürzlich ein ähnliches Paradigma demonstriert, indem sie ein leistungsstarkes VLM direkt an einen mobilen Manipulator angeschlossen haben, wodurch es eine unbekannte Küche aufräumen konnte, ohne task-spezifisches Feintuning. HomeBody erweitert dieses Konzept, indem es die Skill-Schnittstelle formalisiert und sicherstellt, dass die Ausgaben des VLM zuverlässig auf verifizierte, sichere Bewegungsprimitive abgebildet werden. Diese modulare Grundlage ebnet den Weg für die konkrete Übersetzungs-Pipeline, die im Folgenden beschrieben wird.
Wie HomeBody Vision in Bewegung übersetzt
Die Pipeline beginnt, wenn das VLM eine hochstufige Anweisung und die aktuelle RGB-D-Beobachtung erhält. Zunächst wählt es eine geeignete Fähigkeit aus der Bibliothek aus—Navigation, Greifen, Platzieren oder Schubladenöffnung—und gibt dann einen strukturierten Tool-Aufruf aus, der die für diese Fähigkeit erforderlichen räumlichen Ziele spezifiziert. Bei der Navigation ist das Ziel ein 2D-Wegpunkt auf der Belegungskarte; beim Greifen und Platzieren gibt das VLM einen 3D-Objektzentroid und einen Annäherungsvektor aus; bei der Schubladenartikulation liefert es die Griffpose und die Zugrichtung.
Die Tiefe für diese 3D-Ziele stammt von Fast‑FoundationStereo, das auf dem Intel RealSense D435i-Stereopaar läuft und dichte metrische Tiefen in Echtzeit erzeugt. Der Wahrnehmungsstapel fusioniert diese Tiefe mit den RGB-Segmentierungsmasken, um genaue Zentroide und Oberflächennormalen zu berechnen. Ein analytischer Greifplaner konsumiert anschließend die Zielgeometrie, bewertet antipodale Greifkandidaten auf der lokalen Punktwolke und wählt eine kollisionsfreie Pose aus, die den von der VLM bereitgestellten Annäherungsbeschränkungen entspricht.
Sobald die Fähigkeit und ihre Parameter festgelegt sind, führt der niedrigstufige Controller die Bewegungsprimitive aus—ob eine Ganzkörper-Navigationsbahn, eine kartesische Armbewegung zum Greifen oder ein hybrides Kraft-Position-Profil zum Schubladenziehen—während das VLM den Fortschritt überwacht und den nächsten Tool-Aufruf ausgibt. Diese Trennung hält die Reasoning-Schleife leichtgewichtig und die Ausführung deterministisch, wodurch das System mehrere Fähigkeiten zuverlässig in unbekannten Häusern verketten kann. Die wichtigsten technischen Erkenntnisse werden im Folgenden zusammengefasst.
Wichtige Fakten
- HomeBody VLM fungiert als semantische Reasoning-Schicht, die wiederverwendbare Roboterfähigkeiten auswählt und parametrisiert, um eine Null-Schuss-Generalisierung in unbekannten Häusern zu ermöglichen.
- Das System entkoppelt die hochstufige Vision-Sprach-Reasoning von der niedrigstufigen Steuerung und behandelt das VLM als austauschbares kognitives Modul.
- Fast‑FoundationStereo verarbeitet Stereopaare vom Intel RealSense D435i, um dichte metrische Tiefen in Echtzeit für die 3D-Zielschätzung bereitzustellen.
- Ein analytischer Greifplaner bewertet antipodale Kandidaten auf lokalen Punktwolken, um kollisionsfreie Posen zu erzeugen, die durch die vom VLM spezifizierten Annäherungsvektoren eingeschränkt sind.
- Die Fähigkeiten umfassen Navigation, Greifen, Platzieren und Schubladenartikulation, jeweils ausgeführt durch deterministische Bewegungsprimitive, die vom VLM überwacht werden.
- Diese modulare Architektur spiegelt aktuelle Forschung wider, bei der VLMs direkt an mobile Manipulatoren angeschlossen werden, um offene Vokabel-Aufgabenausführung ohne aufgaben-spezifisches Feintuning zu ermöglichen.
Diese Fähigkeiten eröffnen eine Reihe praktischer Implikationen und weisen auf vielversprechende Wege für zukünftige Forschung hin.
Implikationen und zukünftige Richtungen
Die von HomeBody VLM demonstrierte Plug‑in‑VLM‑Architektur weist einen praktischen Weg hin zu generalistischen mobilen Manipulatoren hin, die kognitiv aufgerüstet werden können, ohne den Bewegungsstapel neu zu konstruieren. Da das Vision‑Sprach‑Modul nur strukturierte Tool‑Aufrufe ausgibt, können Forscher größere oder domänenspezialisierte Modelle einsetzen, sobald diese verfügbar werden, während der Greifplaner und der Ganzkörper‑Controller stabil bleiben. Diese Trennung senkt auch die Hürde für den Sim‑to‑Real‑Transfer: In Simulation trainierte Policies können vor der Bereitstellung gegen die gleichen analytischen Primitiven validiert werden.
Die Erweiterung der Fähigkeitsbibliothek um die Manipulation artikulierter Objekte über Schubladen hinaus—wie Türen, Geräte und verformbare Materialien—erfordert reichhaltigere räumliche Deskriptoren. Technologien, die sofortige 3D‑Mesh‑Rekonstruktionen aus Einzelansichten erzeugen, wie Tencent’s InstantMesh, könnten die für kontaktreiches Planning benötigte detaillierte Geometrie liefern, ohne auf Multi‑View‑Fusion zu warten. Die Kopplung solcher schneller Mesh‑Generierung mit der bestehenden Tiefenpipeline würde dem VLM eine vollständigere Szenenrepräsentation bieten und das Schließen von Objekten, das Einhalten von Räumen und die Werkzeugnutzung in überfüllten Häusern ermöglichen.
Häufig gestellte Fragen
Wie behandelt HomeBody VLM Tiefenschätzungsfehler von Fast‑FoundationStereo bei der Generierung von 3D-Zielen?
Das System fusioniert die dichte metrische Tiefeninformation von Fast‑FoundationStereo mit RGB-Segmentierungsmasken und wendet einen Konfidenzfilter an, um Punkte mit geringer Sicherheit zu verwerfen. Außerdem wird ein lokales Punktwolkenglättungsschritt vor der Berechnung von Objektzentroiden und Oberflächennormalen angewendet, um Rauschen zu reduzieren. Wenn der verbleibende Fehler einen Sicherheitsschwellenwert überschreitet, fordert das VLM eine erneute Erfassung an oder fällt auf eine konservative Greifpose zurück.
Kann das modulare VLM durch ein anderes Vision‑Sprach‑Modell ausgetauscht werden, ohne die Fähigkeitsbibliothek neu zu trainieren, und welche Schritte sind dafür erforderlich?
Ja, die Architektur behandelt das VLM als austauschbares kognitives Modul; es muss nur die Tool‑Schnittstelle entsprechen. Um Modelle auszutauschen, müssen Entwickler das gleiche JSON‑Schema für die Fähigkeitsauswahl und Parameterausgabe implementieren, validieren, dass das neue Modell die erforderliche Latenz einhält, und Integrations‑Tests an den Fähigkeits‑Wrappers durchführen. Eine erneute Ausbildung der zugrundeliegenden Bewegungsprimitiven oder der Fähigkeitsbibliothek ist nicht erforderlich.
Welche Rechenanforderungen bestehen für den Betrieb von HomeBody VLM und Fast‑FoundationStereo in Echtzeit auf einem mobilen Manipulator?
Eine typische Bereitstellung verwendet einen NVIDIA Jetson AGX Orin oder eine gleichwertige GPU für die VLM‑Inferenz, gekoppelt an einen mehrkernigen ARM‑CPU für die Verarbeitung von Fast‑FoundationStereo. Die VLM‑Inferenz läuft bei etwa 10–15 Hz, während Fast‑FoundationStereo Tiefen mit 30 Hz liefert, wodurch die gesamte Wahrnehmungs‑zu‑Aktions‑Schleife unter 100 ms bleibt. Der Speicherverbrauch liegt unter 8 GB, sodass der Stapel auf den meisten modernen Edge‑Computing‑Plattformen ausgeführt werden kann.
Last Updated on September 27, 2026 7:24 p.m. by Laszlo Szabo / NowadAIs | Published on September 27, 2026 by Laszlo Szabo / NowadAIs