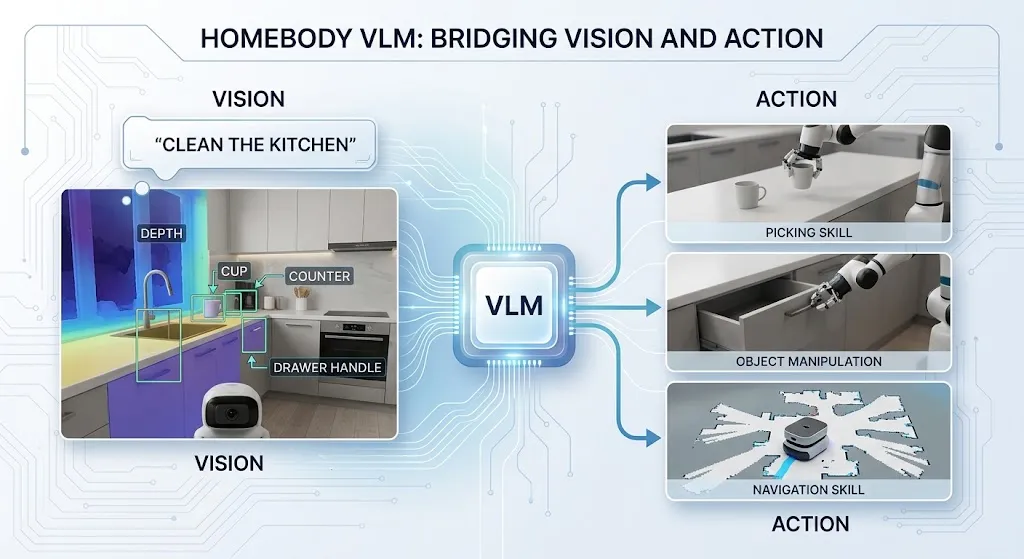
HomeBody VLM: Puentes entre Visión y Acción
El sistema HomeBody introduce una arquitectura modular donde un modelo de visión-lenguaje sirve como capa de razonamiento semántico sobre una biblioteca de habilidades robóticas reutilizables. En lugar de entrenar una política de extremo a extremo para cada nuevo entorno, el VLM interpreta instrucciones de alto nivel y observaciones visuales para seleccionar y parametrizar habilidades existentes—como navegación, agarre o manipulación de objetos—habilitando la generalización de cero disparos en hogares previamente desconocidos.
Este enfoque de plug‑in trata al VLM como un módulo cognitivo reemplazable, desacoplando la percepción y el razonamiento del control de bajo nivel. Investigadores demostraron recientemente un paradigma similar al conectar directamente un poderoso VLM a un manipulador móvil, permitiéndole limpiar una cocina desconocida sin ajuste fino específico para la tarea. HomeBody extiende este concepto formalizando la interfaz de habilidades, asegurando que las salidas del VLM se mapeen de manera confiable a primitivas de movimiento verificadas y seguras. Esta base modular allana el camino para la tubería de traducción concreta descrita a continuación.
Cómo HomeBody traduce la visión en movimiento
El proceso comienza cuando el VLM recibe una instrucción de alto nivel y la observación RGB-D actual. Primero selecciona una habilidad adecuada de la biblioteca—navegación, recogida, colocación o apertura de cajón—y luego emite una llamada estructurada a una herramienta que especifica los objetivos espaciales requeridos por esa habilidad. Para la navegación, el objetivo es un punto de paso 2D en el mapa de ocupación; para la recogida y colocación, el VLM produce un centroide 3D del objeto y un vector de aproximación; para la articulación del cajón, proporciona la pose del mango y la dirección de tracción.
La profundidad para estos objetivos 3D proviene de Fast‑FoundationStereo ejecutándose en el par estéreo Intel RealSense D435i, produciendo profundidad métrica densa en tiempo real. La pila de percepción fusiona esta profundidad con las máscaras de segmentación RGB para calcular centroides y normales de superficie precisos. Un planificador de agarre analítico consume entonces la geometría del objetivo, evaluando candidatos de agarre antipodal en la nube de puntos local y seleccionando una postura libre de colisiones que satisfaga las restricciones de aproximación suministradas por el VLM.
Una vez fijada la habilidad y sus parámetros, el controlador de bajo nivel ejecuta la primitiva de movimiento—ya sea una trayectoria de navegación de todo el cuerpo, un movimiento cartesiano del brazo para el agarre, o un perfil híbrido de fuerza‑posición para la tracción del cajón—mientras el VLM supervisa el progreso y emite la siguiente llamada a herramienta. Esta separación mantiene el bucle de razonamiento ligero y la ejecución determinista, permitiendo al sistema encadenar múltiples habilidades de manera confiable en hogares desconocidos. Los puntos clave técnicos se resumen a continuación.
Datos clave
- HomeBody VLM actúa como una capa de razonamiento semántico que selecciona y parametriza habilidades robóticas reutilizables para la generalización de cero disparos en hogares desconocidos.
- El sistema desacopla el razonamiento de visión-lenguaje de alto nivel del control de bajo nivel, tratando al VLM como un módulo cognitivo intercambiable.
- Fast‑FoundationStereo procesa pares estereoscópicos del Intel RealSense D435i para ofrecer profundidad métrica densa en tiempo real para la estimación de objetivos 3D.
- Un planificador de agarre analítico evalúa candidatos antipodales en nubes de puntos locales para producir posturas libres de colisiones restringidas por los vectores de aproximación especificados por el VLM.
- Las habilidades incluyen navegación, recogida, colocación y articulación de cajón, cada una ejecutada por primitivas de movimiento deterministas monitoreadas por el VLM.
- Esta arquitectura modular refleja investigaciones recientes que conectan directamente VLMs a manipuladores móviles para ejecución de tareas de vocabulario abierto sin ajuste fino específico para la tarea.
Estas capacidades abren una gama de implicaciones prácticas y sugieren vías prometedoras para futuras investigaciones.
Implicaciones y direcciones futuras
La arquitectura de VLM tipo plug‑in demostrada por HomeBody VLM sugiere un camino práctico hacia manipuladores móviles generalistas que pueden actualizarse cognitivamente sin re‑ingeniar la pila de movimiento. Dado que el módulo de visión‑lenguaje solo emite llamadas estructuradas a herramientas, los investigadores pueden intercambiar modelos más grandes o especializados por dominio a medida que se vuelvan disponibles, mientras el planificador de agarre y el controlador de todo el cuerpo permanecen estables. Esta separación también reduce la barrera para la transferencia de sim‑a‑real: las políticas entrenadas en simulación pueden validarse contra los mismos primitivos analíticos antes del despliegue.
Ampliar la biblioteca de habilidades para incluir manipulación de objetos articulados más allá de los cajones—como puertas, electrodomésticos y materiales deformables—requerirá descriptores espaciales más ricos. Tecnologías que producen reconstrucciones instantáneas de mallas 3D desde vistas únicas, como Tencent’s InstantMesh, podrían suministrar la geometría detallada necesaria para planificación rica en contacto sin esperar la fusión multivista. Acoplar dicha generación rápida de mallas con la tubería de profundidad existente daría al VLM una representación más completa de la escena, permitiendo razonar sobre oclusión, contención y uso de herramientas en hogares desordenados.
Preguntas frecuentes
¿Cómo maneja HomeBody VLM los errores de estimación de profundidad de Fast‑FoundationStereo al generar objetivos 3D?
El sistema fusiona la profundidad métrica densa de Fast‑FoundationStereo con las máscaras de segmentación RGB y aplica un filtro de confianza para descartar los puntos de baja certeza. También utiliza un paso de suavizado de nube de puntos local antes de calcular los centroides de los objetos y las normales de la superficie, lo que mitiga el ruido. Si el error residual supera un umbral de seguridad, el VLM solicita una recaptura o recurre a una postura de agarre conservadora.
¿Se puede intercambiar el VLM modular por otro modelo de visión‑lenguaje sin volver a entrenar la biblioteca de habilidades, y qué pasos se requieren?
Sí, la arquitectura trata al VLM como un módulo cognitivo reemplazable; solo necesita coincidir la interfaz de llamada a herramientas. Para intercambiar modelos, los desarrolladores deben implementar el mismo esquema JSON para la selección de habilidades y la salida de parámetros, validar que el nuevo modelo respete la latencia requerida y ejecutar pruebas de integración en los wrappers de habilidades. No es necesario volver a entrenar las primitivas de movimiento subyacentes ni la biblioteca de habilidades.
¿Cuáles son los requisitos computacionales para ejecutar HomeBody VLM y Fast‑FoundationStereo en tiempo real en un manipulador móvil?
Una implementación típica utiliza una NVIDIA Jetson AGX Orin o una GPU equivalente para la inferencia del VLM, emparejada con una CPU ARM de varios núcleos para el procesamiento de Fast‑FoundationStereo. La inferencia del VLM se ejecuta a aproximadamente 10–15 Hz, mientras que Fast‑FoundationStereo entrega profundidad a 30 Hz, manteniendo el bucle de percepción‑a‑acción por debajo de 100 ms. El uso de memoria se mantiene por debajo de 8 GB, lo que permite que la pila se ejecute en la mayoría de las plataformas de cómputo perimetral modernas.
Last Updated on septiembre 27, 2026 7:23 pm by Laszlo Szabo / NowadAIs | Published on septiembre 27, 2026 by Laszlo Szabo / NowadAIs