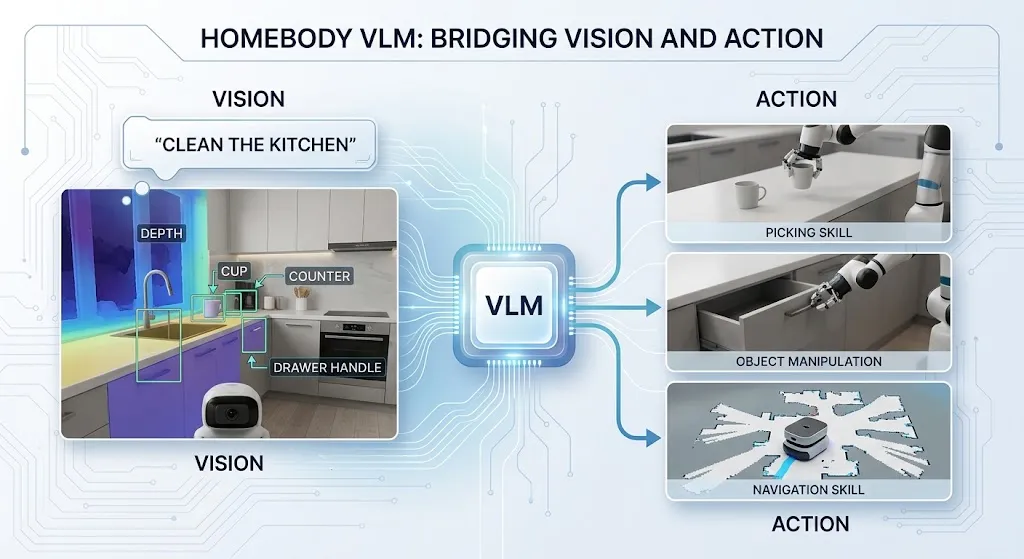
HomeBody VLM: A látás és a cselekvés hídja
A HomeBody rendszer egy moduláris architektúrát mutat be, ahol egy vizuális-nyelvi modell szemantikus okokozási rétegként működik egy újrafelhasználható robotikus készségek könyvtárán felül. Ehelyett, hogy végpontok közötti házirendet tanítana minden új környezethez, a VLM a magas szintű utasításokat és a vizuális megfigyeléseket értelmezi, hogy kiválassza és paraméterezze a meglévő készségeket—mint például a navigációt, a ragadást vagy az objektum manipulációt—ezáltal lehetővé téve a nullás shot általánosítást még nem látott otthonokban.
Ez a beépülő módszer a VLM-et egy cserélhető kognitív modulként kezeli, elválasztva a perceptumot és a okokozást az alacsony szintű vezérlésről. A kutatók napjainkban egy hasonló paradigma bemutatását mutatták be, amikor egy hatékony VLM-et közvetlenül csatlakoztattak egy mobil manipulátorhoz, lehetővé téve számára, hogy tisztítson meg egy ismeretlen konyhát feladat-specifikus finomhangolás nélkül. A HomeBody ezt a fogalmat bővíti ki azzal, hogy formálizálja a készség interfészt, biztosítva, hogy a VLM kimenete megbízhatóan leképezzen ellenőrzött, biztonságos mozgásprimitívekhez. Ez a moduláris alap készen áll a következő részben leírt konkret fordítási folyamat megvalósítására.
Hogyan fordítja le a HomeBody a látást mozgássá
A folyamat akkor kezdődik, amikor a VLM egy magas szintű utasítást és az aktuális RGB-D megfigyelést kapja. Először kiválaszt egy megfelelő készséget a könyvtárból—navigációt, ragadást, elhelyezést vagy ablaknyitást—majd strukturált eszközhívást bocsát ki, amely megadja a készség által igényelt térbeli célokat. A navigáció esetén a cél egy 2D útvonalpont a foglaltsági térképen; a ragadás és elhelyezés esetén a VLM egy 3D objektum középpontját és egy közeledési vektort adja ki; az ablak articúlózás esetén a kezelő pozícióját és húzási irányt adja meg.
A 3D célok mélysége a Fast‑FoundationStereo által terméktelen mélységi adatokat előállító Intel RealSense D435i stereo pár futtatásából származik, valós idejű sebességgel. A perceptációs verem ezt a mélységet összeolvasztja az RGB szegmentálási maszkokkal, hogy pontos középpontokat és felületi normálokat számítson ki. Az analitikus ragadási tervező ezután felhasználja a cél geometriát, értékeli az antipodal ragadási jelölteket a helyi pontfelhőn, és kiválaszt egy ütközést mentes pozíciót, amely kielégíti a VLM által biztosított közeledési korlátokat.
Miután a készség és paraméterei rögzítve lettek, az alacsony szintű vezérlő végrehajtja a mozgásprimitívet—akár testteljes navigációs útvonalat, akár kartesián kar mozgást a ragadáshoz, akár hibrid erő-pozíció profilot az ablak húzásához—mig a VLM figyeli a haladást és kiadja a következő eszközhívást. Ez a elválasztás tartósan kevésbé teherbe vetíti a következtetési hurokot, és determinisztikusan végrehajtja a műveletet, lehetővé téve a rendszer számára, hogy megbízhatóan láncoljon több készséget még nem látott otthonokban. A kulcsfontosságú technikai pontosok lent találhatók összefoglalva.
Kulcsfontosságú tények
- A HomeBody VLM szemantikus okokozási rétegként működik, amely a nullás shot általánosításra képes, még nem látott otthonokban a felhasználható robotikus készségek kijelölését és paraméterezését végzi.
- A rendszer elválasztja a magas szintű vizuális-nyelvi okokozást az alacsony szintű vezérlésről, a VLM-et cserélhető kognitív modulként kezelve.
- A Fast‑FoundationStereo az Intel RealSense D435i stereo párjait feldolgozza, hogy valós idejű sebességgel sűrű metrikás mélységet állítson elő a 3D célok becsléséhez.
- Az analitikus ragadási tervező a helyi pontfelhőkön az antipodal jelölteket értékeli ki, hogy ütközést mentes pozíciókat állítson elő, amelyek a VLM által megadott közeledési vektorokhoz kötött korlátozásokkal kompatibilisek.
- A készségek navigációt, ragadást, elhelyezést és ablak articúlózást tartalmaznak, mindegyik determinisztikus mozgásprimitívek végrehajtásával történik, amelyeket a VLM figyel.
- Ez a moduláris architektúra tükrözi az utóbbi kutatásokat, amelyek a VLMs közvetlen csatlakoztatását mutatják be mobil manipulátorokhoz nyílt szókészletű feladat végrehajtásához feladat-specifikus finomhangolás nélkül.
Ezek a képességek kiterjedt gyakorlati következményekhez vezetnek és jövőbeli kutatás hopeful útvonalait jelzik.
Következmények és jövőbeli irányok
A HomeBody VLM által demonstrált beépülő VLM architektúra azt jelzi, hogy egy gyakorlati út vezet a általános mobil manipulátorok felé, amelyeket kognitív frissítéssel lehet fejlesztani anélkül, hogy át kellene tervezni a mozgási veremet. Mivel a vizuális-nyelvi modul csak strukturált eszközhívéseket bocsát ki, a kutatók cserélhetnek nagyobb vagy tartomány-speciális modelleket, miközben a ragadási tervező és a testteljes vezérlő stabil marad. Ez a elválasztás csökkenti a szimuláció-valós környezet közötti átmenet akadályát is: a szimulációban betanított politikákat ugyanazok az analitikus primitívek ellen érvényesíthetik elő a telepítés előtt.
A készségkönyvtár kiterjesztése a fiókokon túli artikulált objektumok manipulálásához—mint ajtók, háztartási gépek és deformálható anyagok—gazdagabb térbeli leírásokat igényel. A egyetlen nézetből azonnal 3D háló rekonstrukciót előállító technológiák, például a Tencent InstantMesh, biztosíthatják a kapcsolatok gazdag tervezéséhez szükséges részletes geometriát anélkül, hogy várakoznának a több nézetes fusiónra. A gyors hálógenerálás összekapcsolása a létező mélységi folyamatával a VLM-et teljesítményesebb scénáképessé teszi, lehetővé téve a zárlatok, tartalom és eszközhasználat okoskodását a zsúfolt otthonokban is.
Gyakran Ismételt Kérdések
Hogyan kezeli a HomeBody VLM a Fast‑FoundationStereo által előállított mélybecslési hibákat, amikor 3D célokat hoz létre?
A rendszer a Fast‑FoundationStereo által előállított sűrű metrikás mélységet fúziózza az RGB szegmentálási maszkokkal, majd megbízhatósági szűrőt alkalmaz a bizonytalanságos pontok eldobásához. Emellett egy helyi pontfelhő-simítási lépést is használ, mielőtt az objektum középpontjait és felületnormalvektorokat számolnám, ami csökkenti a zajt. Ha a maradék hiba túllépi a biztonsági küszöböt, a VLM újragát kéri vagy visszavonul egy konzervatív ragadási pozícióba.
Lehetséges-e a moduláris VLM-et egy másik vizuális-nyelvi modellre cserélni anélkül, hogy újratanítanánk a készségkönyvtárat, és milyen lépések szükségesek?
Igen, az architektúra a VLMet cserélhető kognitív modulként kezeli; csak az eszköz-hívási interfészt kell egyezni. A modell cseréjéhez a fejlesztőknek meg kell valósítaniuk ugyanazt a JSON-sémát a készségkijelöléshez és paraméterkimenethez, ellenőrizniük kell, hogy az új modell betartja-e a szükséges késleltetést, és integrációs teszteket kell futtatniuk a készség burkolókon. Az alap mozgásprimitívek vagy a készségkönyvtár újratanítása nem szükséges.
Milyen számítási igények vannak a HomeBody VLM és a Fast‑FoundationStereo valós idejű futtatásához egy mobil manipulátoron?
Egy tipikus telepítésben az NVIDIA Jetson AGX Orin vagy ekvivalens GPU-t használják a VLM konklúzióhoz, míg egy többmagos ARM CPU-t a Fast‑FoundationStereo feldolgozáshoz. A VLM konklúziója körülbelül 10–15 Hz-es sebességgel fut, míg a Fast‑FoundationStereo 30 Hz-es sebességgel szállítja a mélységet, így a teljes észlelés‑cselekvés körkép 100 ms alatt marad. A memóriaigény 8 GB alatti, lehetővé téve, hogy a verem fusson a legtöbb modern peremhálózati számítási platformon.
Last Updated on szeptember 27, 2026 7:24 du. by Laszlo Szabo / NowadAIs | Published on szeptember 27, 2026 by Laszlo Szabo / NowadAIs